Co oznacza generowanie diagramów z kodu#
Narzędzie analizuje wybrany kod lub jego strukturę i buduje z niej model, diagram albo oba te artefakty. Często mówi się o inżynierii odwrotnej. W praktyce program może odczytać deklaracje klas, interfejsów, metod i zależności, a następnie przedstawić je na diagramie. Zakres zależy od języka, parsera, konfiguracji i tego, czy analizowane są źródła, skompilowane pliki czy dane z wykonania programu.
Trzeba odróżnić trzy operacje: tworzenie diagramu z istniejącego kodu, generowanie kodu z modelu oraz synchronizację w obu kierunkach. Każda ma inne źródło danych i ryzyka. Diagram wygenerowany z kodu opisuje to, co narzędzie potrafiło odczytać, a niekoniecznie intencję projektową, wymagania ani całą architekturę.
Typowy przebieg#
Najpierw wybierz repozytorium, moduły i wersję kodu, które mają zostać przeanalizowane. Następnie skonfiguruj język, katalogi źródłowe, zależności i wykluczenia. Parser buduje reprezentację programu; narzędzie wybiera elementy i relacje, po czym tworzy model lub widok. Na końcu człowiek filtruje wynik, nadaje mu cel i sprawdza, czy strzałki oraz typy relacji odpowiadają rzeczywistości.
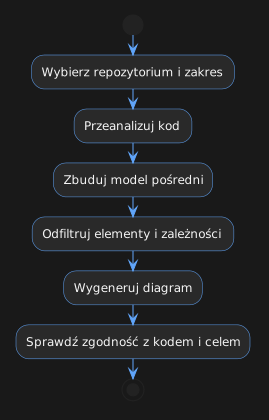
Wynik należy odnosić do konkretnej wersji kodu. Jeżeli kod zmieni się po analizie, diagram może być już nieaktualny. Zapisz wersję lub commit, konfigurację narzędzia, zakres modułów i filtry, aby dało się odtworzyć rezultat.
Jakie diagramy da się uzyskać#
Najczęściej spotykanym wynikiem jest diagram klas pokazujący typy, pola, metody i wybrane relacje, takie jak dziedziczenie, implementacja interfejsu czy zależność. Niektóre narzędzia potrafią tworzyć diagramy pakietów, komponentów, obiektów albo sekwencji na podstawie śladów wykonania. Diagram sekwencji ze statycznej analizy wnioskowanej ścieżki wywołań nie jest tym samym co zapis rzeczywistego przebiegu programu; profilowanie lub tracing może dostarczać innych danych.
Automatyczne rozpoznanie relacji domenowych, intencji, reguł biznesowych i architektonicznych granic jest znacznie trudniejsze niż odczytanie składni klas. Zwykłe wywołanie metody nie zawsze jest UML-zależnością, asocjacją czy kompozycją. Narzędzie może pokazać tylko syntaktyczne powiązania albo zastosować własne reguły. Sprawdź legendę i definicję wygenerowanych krawędzi.
Ograniczenia i typowe pułapki#
Duży system może wygenerować diagram z setkami elementów i połączeń. Taki obraz często jest technicznie poprawny, lecz nie odpowiada na żadne konkretne pytanie. Zacznij od pytania: które moduły współpracują, gdzie przebiega dziedziczenie, jak wywołania przechodzą przez warstwę usługi albo które klasy implementują interfejs? Potem ogranicz zakres do odpowiadających mu elementów.
Refleksja, generics, dynamiczne wiązanie, dependency injection, makra, kod generowany, frameworki i konstrukcje specyficzne dla języka mogą utrudniać analizę. Brak relacji na diagramie nie dowodzi, że jej nie ma; relacja pokazana automatycznie może być zbyt ogólna albo fałszywie sugerować semantykę. Wyniki różnią się między narzędziami i konfiguracjami.
Wygenerowany diagram bywa szczegółowy na poziomie implementacji, a jednocześnie pomija kontekst biznesowy. Nie zastępuje modelu docelowego ani przeglądu architektury. Nie należy też automatycznie nadpisywać nim ręcznie utrzymywanych diagramów: zmiany intencjonalne, komentarze i abstrakcje mogą zniknąć.
Jak utrzymać wynik przydatny#
Podziel wygenerowany model na widoki o jednej roli. Ukryj szczegóły bibliotek zewnętrznych, wygenerowany kod i elementy bez znaczenia dla pytania. Grupuj klasy według pakietów lub warstw, stosuj filtry, limity głębokości i kryteria wyboru zależności. W razie potrzeby przygotuj osobne widoki: publiczne API modułu, wewnętrzna struktura pakietu, hierarchia dziedziczenia albo wybrana ścieżka wywołań.
Po wygenerowaniu sprawdź nazwy i kierunki, prawdziwość krawędzi, widoczność istotnych elementów, czytelność, wersję analizowanego kodu oraz eksport. Oznacz diagram jako wygenerowany i podaj jego źródło oraz datę albo commit. Jeśli był ręcznie poprawiany, zapisz rozdział między automatyczną częścią a redakcyjnymi zmianami.
Automatyzacja w zespole#
Analizę można uruchamiać okresowo lub jako część procesu CI, o ile narzędzie i licencja na to pozwalają. Pipeline powinien korzystać z ustalonej wersji programu, jawnych opcji, kontrolowanych zależności i deterministycznego zakresu. Określ, czy wynik zapisywany jest jako model, obraz, dokumentacja czy wszystkie te formy.
Nie aktualizuj automatycznie dokumentacji głównej samym faktem, że generowanie zakończyło się powodzeniem. Zmiany wymagają przeglądu, a szum wynikający z układu lub wersji narzędzia może przysłonić ważne różnice. Ustal próg istotnych zmian, sposób porównania i właściciela akceptującego publikację.
Kiedy generować diagramy z kodu#
Inżynieria odwrotna pomaga poznać nieznany lub odziedziczony system, odnaleźć zależności i rozpocząć dokumentowanie. Jest przydatna także do sprawdzania, czy implementacja odbiega od uzgodnionego projektu. Najlepiej działa jako punkt wyjścia do analizy, kiedy źródło jest dostępne, a pytanie ma ograniczony zakres.
Jeśli celem jest wyjaśnienie intencji, wymagań lub rozwiązania docelowego, twórz model świadomie i użyj kodu jako jednego ze źródeł informacji. Nie utożsamiaj automatycznego obrazu kodu z kompletnym modelem UML. Zawsze opisz, co jest wygenerowane, co wybrano ręcznie i czego wynik nie pokazuje.